搜索与相关性
Nowledge Mem 的搜索与排序机制
搜索由多信号评分、时间衰减和反馈循环驱动。下面逐一说明。
评分管道
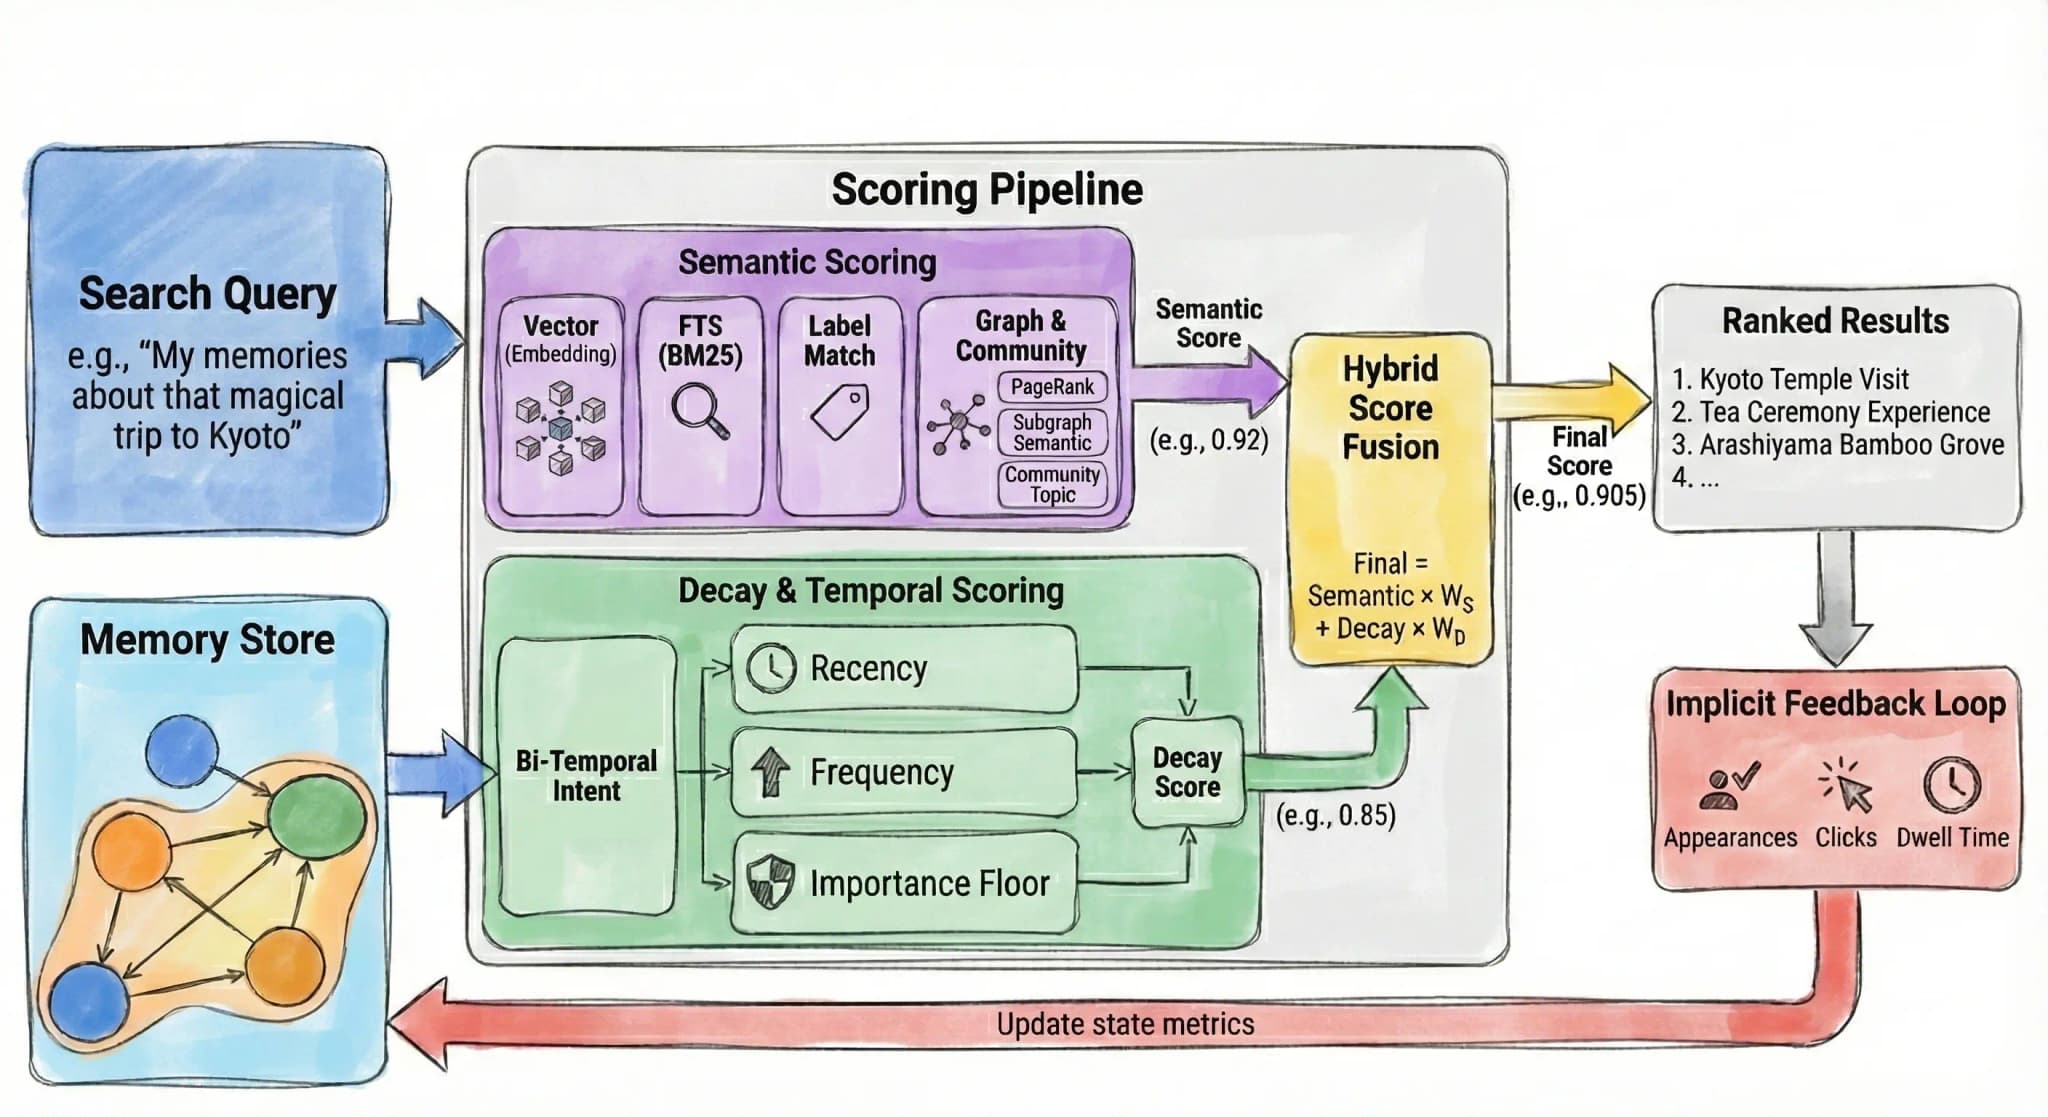
搜索时,Nowledge Mem 不只匹配关键词,而是综合多个信号来排列结果。
语义评分
这一组信号负责找出和你想找的内容意思对得上的记忆:
- 按含义搜索:按语义相似度查找记忆,而不只是精确字面匹配。搜索"设计模式",也能找到关于"架构方法"的记忆。
- 关键词搜索:用 BM25 排序,抓住精确短语和技术术语。
- 标签匹配:带有匹配标签的记忆会被提上来。
- 图遍历:顺着实体和主题社区,找到相互关联的记忆。
衰减、置信度与时间评分
这一组信号会根据新鲜度、验证程度和你的使用情况来调整排序:
- 时效性:最近访问过的记忆得分更高。衰减按指数曲线计算,半衰期约 30 天。
- 频率:你反复访问的记忆会越来越稳固(按对数缩放,收益递减)。
- 重要性底线:重要性高的记忆即使没怎么用,也保有一个最低的可见度。
- 置信度:被使用过、并在知识图谱里建立了连接的记忆会得到一点加成。置信度只随证据增长,不会下降。
- 时间匹配:事件时间和你查询对得上的记忆会被提升(仅深度模式)。
这几组信号汇总成最终分数,决定结果的排序。
记忆衰减
记忆会随时间自然消退,使用即强化。
工作原理
时效性:昨天访问的记忆,得分比三个月前的高出很多。半衰期 30 天的意思是:只要不再访问,分数大约每个月减半。
频率:第 10 次访问的作用,比第 100 次大得多。早期反复访问把记忆"焊"得更牢,之后收益递减。
重要性底线:重要性高的记忆永远不会完全衰减。即使长期没访问,也保有最低的可见度,避免基础知识丢失。
搜索强化
自 v0.6.6 起
从 v0.6.6 开始,每次搜索展示都会更新记忆的最后访问时间和访问次数,自动增强其新鲜度分数。
在此之前,只有真正点开才会更新新鲜度。现在,出现在搜索结果里也算一次轻度访问,避免那些一直有用的记忆悄悄衰减下去。
置信度
自 v0.6.7 起
置信度评分在每日新鲜度刷新时计算。
和衰减各自独立,每条记忆还会积累一个置信度评分,反映它被验证到什么程度。置信度从一个基线起步,证据越多就越高:
- 搜索使用:展示次数、点击和阅读时间
- 知识图谱:被其他记忆确认或丰富的记忆,或被用作知识结晶来源的记忆
新鲜度会随时间衰减,置信度则只增不减。一条经常被访问、点击、并和其他知识关联起来的记忆,在语义匹配相当的情况下,得分会比刚创建的记忆更高。
这个影响不大(置信度约占最终评分的 5%),但能让沉淀下来的知识始终占一点先手。
这意味着什么
- 常用的知识保持新鲜,出现在搜索结果里也算
- 旧记忆不会消失,只是在同样相关时排得靠后一些
- 不管你怎么访问,重要的知识都会一直留着
- 被验证过的记忆会得到一点排名加成
- 系统会自动从你的使用习惯里学习
自动维护
自 v0.6.6 起
这些功能为可选启用,位于设置 → 处理 → 高级。
为了保持衰减分数准确和记忆质量,Nowledge Mem 可以运行后台维护:
- 新鲜度刷新:每日任务重新计算所有记忆的衰减和置信度分数,使排序保持准确。它只更新分数,不会归档、合并、删除或改写记忆。
- Memory Maintenance:先审查再维护的任务,用来发现记忆增长压力。它会在 Timeline 里准备审查建议:低风险事实/事件可以移出日常召回,重要的偏好、决定、流程、计划、经验和上下文则进入语义整理。
- 记忆整理:每周任务识别相似或冗余记忆的聚类,可以创建关联、摘要或审查项。它不会静默删除你保存的记忆正文。
时间理解
Nowledge Mem 理解两种时间。
事件时间 vs 记录时间
事件时间是事情真正发生的时间:
- "2020年的产品发布"
- "上季度的决定"
- "在我们迁移之前"
记录时间是你保存记忆的时间。你今天可能记录一条关于2020年事件的记忆。
这对于像"关于2020年事件的最近记忆"这样的查询很重要:你最近保存的东西(记录时间)关于2020年的事件(事件时间)。
时间意图检测
深度模式功能
时间意图检测需要深度模式搜索。在快速模式下,时间引用仅按关键词匹配。
在深度模式下,系统解释时间引用:
| 查询 | 理解 |
|---|---|
| "2023年的决定" | 事件时间:2023 |
| "最近的记忆" | 记录时间:最近 |
| "关于2020年的最近记忆" | 事件:2020,记录:最近 |
| "迁移之前" | 事件:在那个事件之前 |
"上季度"、"大约 2020 年"、"今年初"这类模糊说法,会被转换成实际可用的时间过滤条件。
日期精度
当你保存关于"2020年初"的记忆时,系统:
- 规范化为可搜索的日期(2020-01-01)
- 跟踪精度级别(年、月或日)
- 保留原始含义以实现准确匹配
这让"2020年的记忆"(年精度)与"2020年1月的记忆"(月精度)工作方式不同。
反馈循环
你的使用模式持续改进搜索相关性。
我们跟踪什么
| 信号 | 捕获的内容 |
|---|---|
| 展示次数 | 记忆在结果中出现的频率 |
| 点击 | 当你打开记忆查看详情时 |
| 停留时间 | 你花多长时间阅读 |
如何改进搜索
- 点击率高,说明这条记忆确实有用
- 停留时间长,说明内容有价值
- 经常被展示却没人点,可能说明相关性在下降
你什么都不用做,正常使用就行。
自动标签
自 v0.6.7 起
创建新记忆时自动分配标签。
每当你创建一条记忆,后台智能会读一遍内容,给它打上 2–4 个描述性标签。它会优先复用已有标签,并统一用小写加连字符的写法(如 machine-learning 或 project-alpha)。这样一来,记忆从创建那一刻起就归好了类,你不用自己动手标记。
图驱动的发现
知识图谱通过实体连接扩展搜索范围。
记忆如何连接
每条记忆可以链接到:
- 实体:提到的人员、概念、技术、地点
- 其他记忆:通过共享实体或关系
- 社区:图分析检测到的主题集群
通过连接搜索
经由实体:即使标签不同,也能借助 PostgreSQL、索引这类共享实体,找到关于"数据库优化"的记忆。
经由社区:搜索"认证"时,可能会带出你"安全实践"社区里的记忆。
图扩展:从一条记忆出发,顺藤摸瓜找到相关联的知识。
搜索模式
所有界面都有两种模式可用:
快速模式
- 通常不到100毫秒响应
- 直接语义和关键词匹配
- 实体和社区搜索,无需语言模型分析
- 最适合快速查找
深度模式
- 完整的语言模型分析
- 时间意图检测(例如,"最近在做的;过去十年的社交活动")
- 查询扩展以获得更好的召回率
- 上下文感知的策略加权
- 更适合探索性搜索
两种模式都适用于主搜索、全局启动器和 API。
结果透明度
每条结果都附带排序原因。
搜索查询详情
每次搜索后,你可以查看你的查询如何被解释的详细分析:
- 使用了哪些搜索策略
- 时间意图检测结果(在深度模式下)
- 查询扩展和实体提取
分数分解
把鼠标停在任意一条结果的分数上,就能看到它是怎么算出来的:
- 语义分数:内容与你的查询匹配程度
- 衰减分数:基于时效性和频率的新鲜度
- 置信度:通过使用和图连接的验证程度
- 时间提升:事件时间相关性(适用时)
- 图信号:实体和社区连接
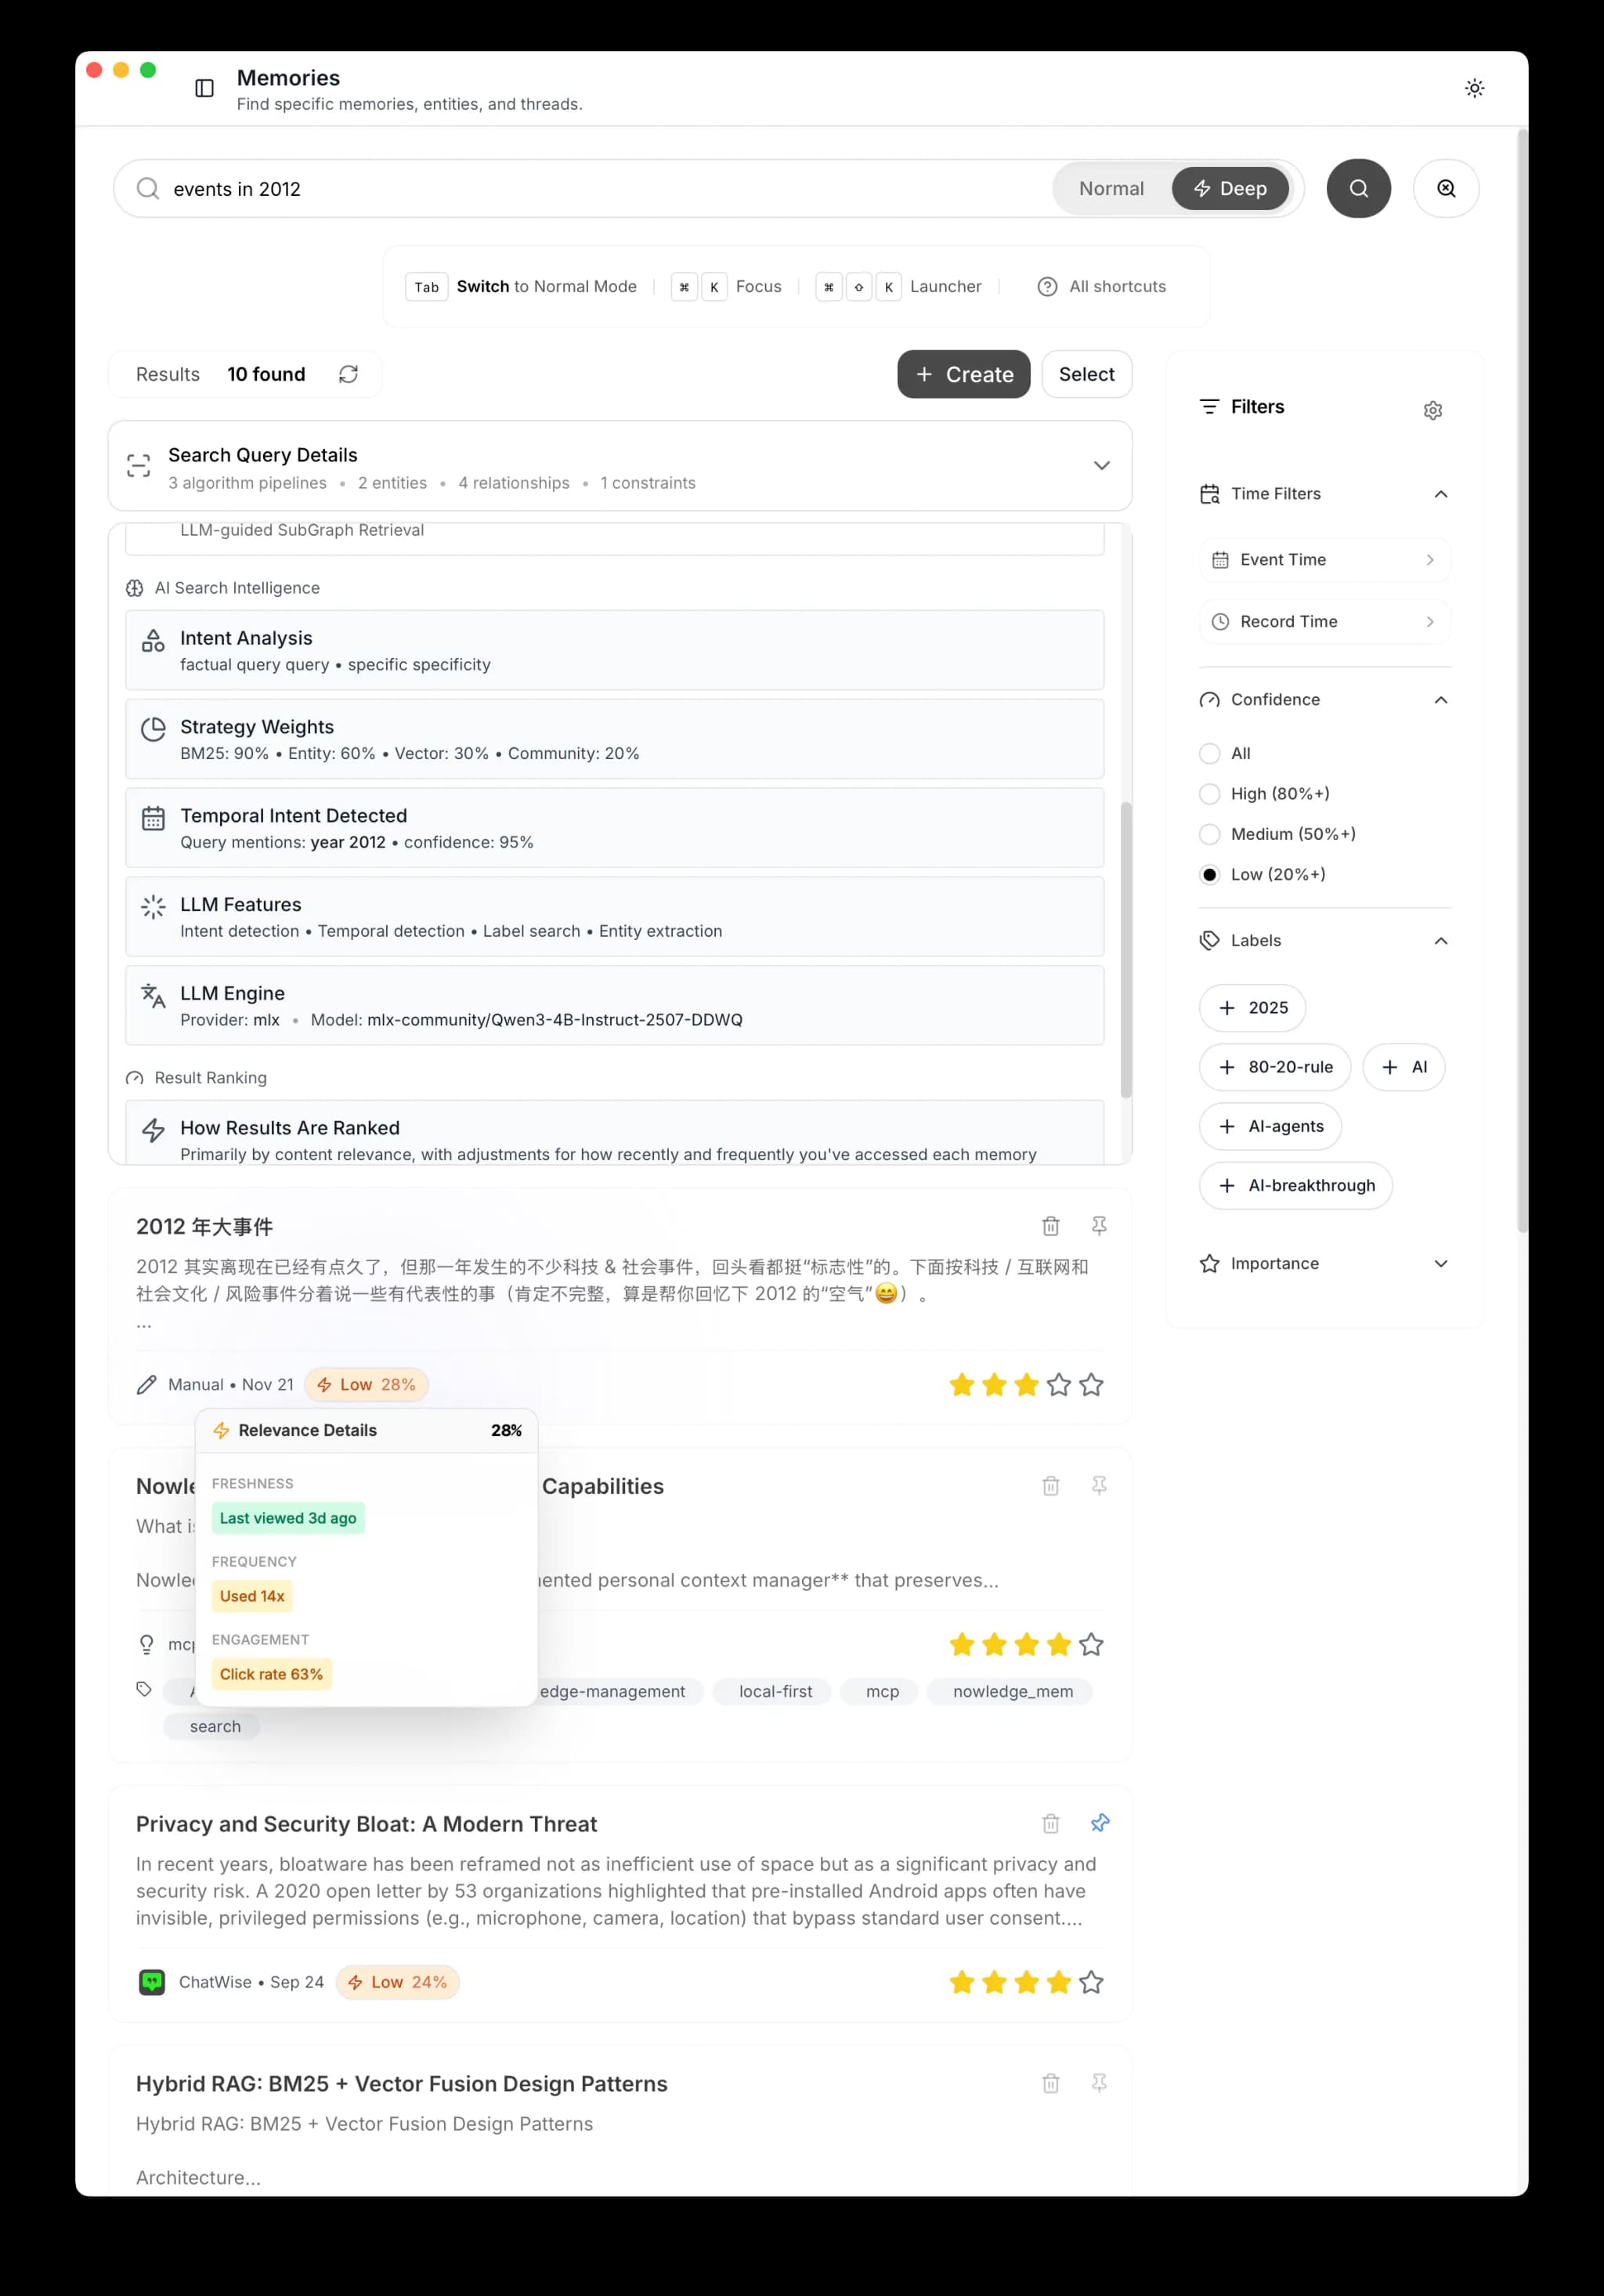
这帮助你理解使用模式如何影响排序,以及某条记忆为什么会出现在特定查询中。