OpenClaw × Nowledge Mem
5 分钟配置指南,让 OpenClaw 同时拥有无损会话记忆和跨工具共享记忆。
给你的智能体
把这行交给你的智能体。它应该先使用统一安装指南;这一页保留为行为说明和排障参考:
读取 https://mem.nowledge.co/SKILL.md,按其中说明为 OpenClaw 安装或更新 Nowledge Mem。用 nmem status 和 Context Bundle 或 Working Memory 检查验证结果,并总结你改了什么。openclaw plugins install clawhub:@nowledge/openclaw-nowledge-mem配置好之后:你在 OpenClaw 里聊出来的内容会进 Mem,能搜得到;定时跑的那条线默认不会挤进「对话」列表。该留的重要时刻仍可提炼成带 sourceThreadId 的记忆,你在别的工具里存下来的知识也一样能被读到。
此外,Mem 不只是把文字堆在一起。相关知识会连成图谱,观点怎么变会有迹可循;开了后台处理后,工作记忆简报、冲突提示、多来源综合出的 crystals 也会回流到 OpenClaw。
第一次成功应该是什么样
最快的验证方式很简单:先记住一条事实,在新会话里把它问回来,再确认这段会话本身也已经成为可搜索的线程。
已经发布到 ClawHub
这个包现在已经发布在 ClawHub。想明确指定来源时,直接使用 clawhub: 前缀即可。若省略前缀,OpenClaw 也会优先从 ClawHub 解析,再回退到 npm。
开始之前
需要准备:
- Nowledge Mem 已在本地运行(安装)
- OpenClaw 2026.5.3 或更高版本(OpenClaw 入门)。旧的 2026.4.x 版本可能会在安装当前 ClawHub 包时先报
archive integrity mismatch,导致插件还没装上就被拒绝。 nmemCLI 在你的 PATH 中。在 Nowledge Mem 中,打开 设置 → 偏好设置 → 开发者工具 → 安装 CLI。或独立安装:pip install nmem-cli
nmem status        # 应显示 Nowledge Mem 正在运行
openclaw --version
设置
安装插件
openclaw plugins install clawhub:@nowledge/openclaw-nowledge-mem安装器会自动启用插件,并把 OpenClaw 的 memory slot 切换到 openclaw-nowledge-mem。在当前一些 OpenClaw 版本里,这个安装流程还可能把 plugins.slots.contextEngine 一起写成 openclaw-nowledge-mem。插件 0.8.18+ 会把它当作兼容别名自动接受,所以安装后不需要再手改本地配置。如果你是手动维护配置,仍然建议使用规范的上下文引擎 id:nowledge-mem。
如果你之前从 ClawHub 安装时遇到 dangerous code patterns detected,请更新到
0.8.17+。这个版本会把测试文件排除在发布包之外,OpenClaw 安装时扫描到的就只
剩真正会运行的插件代码。
如果你更喜欢默认解析路径,这样写也可以:
openclaw plugins install @nowledge/openclaw-nowledge-mem更新到最新版本:
openclaw plugins install clawhub:@nowledge/openclaw-nowledge-mem --force这会从 ClawHub 重新拉取最新版并替换本地插件。如果你的 OpenClaw 本地记录曾经被固定
到某个具体版本,不要用 openclaw plugins update openclaw-nowledge-mem,直接用上面
这条命令。
如果安装时报 archive integrity mismatch,先升级 OpenClaw,再重新执行上面的
--force 安装命令。
安全地自定义
OpenClaw 这条连接没有单独的项目级指引文件。
- 想做持久化行为调整,优先改插件设置和 OpenClaw 配置
- 想改变记忆风格、语言或回忆策略,优先走 agent / prompt 配置
- 不要直接去改
~/.openclaw/extensions/下安装好的插件源码
完整对照表见 安全地自定义连接行为。
可选但推荐:把非内置插件加入信任 allowlist
如果 OpenClaw 提示 plugins.allow 为空,可以加入:
{
  "plugins": {
    "allow": ["openclaw-nowledge-mem"]
  }
}
如果你还用了 plugins.load.paths 或 openclaw plugins install --link 的本地副本,也要一起检查。OpenClaw 的 allowlist 按插件 id 生效,不会固定来源路径。
重启 OpenClaw 并验证
openclaw nowledge-mem status看到 Nowledge Mem 可访问即配置成功。
如果你不是通过 openclaw plugins install 安装,而是手动维护配置,请确认 plugins.slots.memory 是 openclaw-nowledge-mem,并且 plugins.entries.openclaw-nowledge-mem.enabled 为 true。
本地模式不需要 API key。如果你要连接远程 Nowledge Mem 服务器,请设置 apiUrl;如果那台服务器开启了认证,再额外设置 apiKey。
Spaces
OpenClaw 比一般单 Agent 工具更适合做 lane 映射,但前提是宿主真的知道当前是谁在运行。
- 如果一个 OpenClaw profile 或进程本来就属于一个固定 lane,直接设置
space - 如果你的启动器已经提供可信的身份变量,再使用
spaceTemplate - 如果没有可靠的身份信号,就不要硬做自动路由。一个 profile 对应一个 space,往往比“看起来聪明”的猜测更稳
如果只是单 lane 使用,也可以直接用 NMEM_SPACE="Research Agent" 启动当前 OpenClaw 进程。
验证配置(1 分钟)
在 OpenClaw 聊天中依次执行:
/remember 我们为任务事件选择了 PostgreSQL/recall PostgreSQL- 应立即找到/new- 开启新会话- 问:
任务事件的数据库我们选的什么?- 跨会话记住了 - 问:
这周我都做了什么?- 按周浏览 - 问:
2月17日我在忙什么?- 精确到某一天 /forget PostgreSQL 任务事件- 删除干净
如果以上七步都顺利,记忆系统已完整运作。
你能做什么
对话留下,定时任务不塞进来
你在窗口里亲自聊的内容会落成线程,以后搜得到。像 cron-worker 这种自动化会话,插件会直接跳过,不和你的手谈挤在同一张列表里。真有要留的东西,再提炼成结构化记忆,用 sourceThreadId 一键回到原文。
用图谱记忆,而不是平铺的存档
每条记忆都可以连到相关实体、同一主题更早或更新的版本,以及它来自的源对话。这样 OpenClaw 做的就不只是关键词检索,而是能追踪一个决策怎么变化、它和哪些主题相连、答案来自哪里。
让知识在后台继续成长
当你在 Nowledge Mem 里开启 Background Intelligence 后,系统会在会话结束后继续工作:去重重叠内容、找出矛盾、生成 Working Memory 简报,并在多条记忆逐渐收敛时形成知识结晶(crystals)。下次你使用 OpenClaw 时,这些结果就已经在那里了。
记住任何事情
告诉 AI /remember 我们决定不用微服务,原因是团队太小,下周换一个会话,直接问"微服务那个决定是怎么说的",它能找到。
按日期找回工作内容
问"上周二我在做什么",AI 会列出那天你保存的内容、添加的文档、生成的洞察。支持指定具体日期,不只是"最近 N 天"。
把其他 AI 工具里的知识也带进 OpenClaw
你在 Claude 里得到的结论、在 Cursor 里做的决定、在浏览器 AI 聊天里保存的内容,或者从旧线程导入的历史,都可以进入同一个记忆层。OpenClaw 不是孤立工作的,它接入的是一整套持续增长的上下文系统。
追溯一个决策的来龙去脉
问 AI "这条记忆是怎么来的、和什么有关",它会展示:这条知识的原始来源文档、哪些相关记忆被合成为了更高层的洞察、这个认识随时间怎么变化过。
可选:让每次会话一开始就带着上下文
开启 sessionContext 后,Nowledge Mem 会在第一轮回复前注入 Context Bundle / Working Memory 和相关记忆。这样 OpenClaw 从一开始就知道你的身份、分区、规则和当前重点。默认模式下不会自动注入这部分上下文,AI 仍然有完整的记忆工具和一条简短的系统提示,但它会自己判断什么时候搜索。
保存时带上类型和时间
你不只是在保存文字,你在记录结构化的知识。告诉 AI "记住这是一个决策,发生在 2026 年 2 月",它会以正确的类型和时间存进知识图谱。支持 8 种类型:事实、偏好、决策、计划、流程、学习、背景、事件。
追溯记忆的来源对话
当一条记忆是从对话中提炼出来的,它会包含 sourceThreadId。AI 可以用 nowledge_mem_thread_fetch 获取完整对话,查看当时说了什么、做了什么决定、结论是怎么得出的。
直接搜索过去的对话
问"找一下我们讨论 Redis 缓存的那次对话",AI 会用 nowledge_mem_thread_search 找到匹配的对话线程和消息片段。然后用 nowledge_mem_thread_fetch 逐页获取完整消息。
斜杠命令快捷方式:/remember、/recall、/forget
工作原理
每轮对话的工作流
每次你发送消息,插件会在 AI 处理之前注入行为引导。AI 随后决定调用哪些工具。
行为技能和始终在线的引导提示 AI 回答前先搜索、做完决定后保存。每个工具的触发时机:
| 场景 | 工具 | 做什么 |
|---|---|---|
| 用户提问 | memory_search | 回答前搜索知识库,返回 sourceThreadId |
| 做了决策、学到新东西 | nowledge_mem_save | 结构化保存:类型 + 标签 + 时间 |
| "上周我在做什么?" | nowledge_mem_timeline | 按天分组的活动流,支持精确日期 |
| "X 和 Y 有什么关联?" | nowledge_mem_connections | 图谱遍历:边、实体、演化链、来源 |
| 需要启动上下文或今日重点 | nowledge_mem_context | 优先读取 Context Bundle,旧版 CLI 回退到 Working Memory |
记忆有 sourceThreadId | nowledge_mem_thread_fetch | 获取完整来源对话,支持分页 |
| "找一下我们讨论 X 的对话" | nowledge_mem_thread_search | 按关键词搜索过去的对话 |
| "忘掉 X" | nowledge_mem_forget | 按 ID 或搜索词删除 |
| "我的配置对吗?" | nowledge_mem_status | 显示配置、连接状态和版本 |
会话生命周期(自动捕获)
会话结束时,对话自动被捕获并可选地提炼为结构化记忆。无需用户操作。
要点:
- 你在 OpenClaw 里正常聊出来的会话,会像其他已连接的助手一样自动进 Mem,搜得到。
- 定时任务、cron 那类隔离运行默认不同步。诊断里看到
cron-worker不稀奇;对话列表刻意不收它们,是产品上的选择,不是漏了。 - 提炼跟着「对话真的变长了」走:
agent_end,或者开了上下文引擎时的普通轮次。只有压缩检查点的那一瞬,不会单独再开一轮提炼。 - 如果你开启了上下文引擎,提示词组装会交给它;但线程捕获仍保留生命周期钩子做兜底。这样更稳,不会因为某一条运行路径漏掉一次回调,就把整段会话丢掉。
- 提炼结果带
sourceThreadId,要回原文一戳就行。
渐进式检索(记忆 -> 线程 -> 消息)
从对话中提炼的记忆携带 sourceThreadId,形成检索链:搜索记忆 -> 追溯来源对话 -> 分页读取完整消息。
两个进入过去对话的入口:
- 从记忆出发:
memory_search或memory_get返回sourceThreadId,然后获取来源对话 - 直接搜索:
nowledge_mem_thread_search按关键词查找对话,然后获取任意结果
三种模式
插件支持三种运行模式。根据你想要多少保障、愿意花多少 token 预算来选择。
| 模式 | 配置 | 行为 | Token 开销 |
|---|---|---|---|
| 默认(推荐) | sessionContext: false | AI 按需调用 10 个工具。会话结束时自动捕获 + 提炼。 | 开销最低,由 AI 自己判断何时搜索 |
| 会话上下文 | sessionContext: true | 每次提示时自动注入 Context Bundle / Working Memory 和相关记忆,同时仍可使用全部 10 个工具。 | 每轮提示更大,但从第一轮开始就带着上下文 |
| 最小模式 | sessionDigest: false | 仅工具调用,不自动捕获。 | 只保留那条简短系统提示的开销 |
选哪个模式?
- 大多数用户:从默认模式开始。AI 每轮收到行为引导,提示它回答前先搜索、做完决定后保存。大多数对话场景下效果良好。
- 短会话或需要高准确性:开启
sessionContext。这确保从第一轮开始就有相关记忆在上下文中,AI 不需要自行判断是否搜索。代价是每轮提示会更大。 - 完全手动控制:设置
sessionDigest: false。你自己决定什么该保存(通过/remember或nowledge_mem_save),不会自动捕获任何内容。
sessionContext - 会话上下文注入
开启后,插件在每次提示时自动注入上下文:
- 优先读取 Context Bundle:用户身份、Agent 身份、当前分区、行为规则、Working Memory 和 KFS 路径;旧版 CLI 会回退到 Working Memory
- 根据当前消息在知识图谱中搜索相关记忆
- 将检索到的内容作为这次回答的上下文插入,同时把稳定的行为引导放在系统提示区域
开启 sessionContext 后,行为引导会自动调整,告诉 AI 上下文已经注入,memory_search 仅用于特定的后续查询,而非广泛的回忆。这样可以避免重复搜索相同的上下文。
适用于短会话和关键工作流,确保从第一轮开始就有完整的记忆上下文。
sessionDigest - 对话线程 + LLM 智能提炼(默认开启)
在会话生命周期事件(agent_end、after_compaction、before_reset)时执行两步操作:
1. 对话线程保存(你亲自聊的才算)。 整段对话会追加进 Mem 的持久线程,用 nowledge_mem_thread_search 能搜到。OpenClaw 给定时、cron 那类隔离运行发了另一套会话键,插件碰到就跳过,免得后台任务和你的手谈叠在同一条时间线上。
2. LLM 智能提炼(有价值时才执行)。 保存线程后,先用一次轻量级 LLM 筛选判断对话中是否有值得保存的内容(决策、洞察、偏好、事实)。如果有,执行完整的提炼流程,提取带有正确类型、标签和时间信息的结构化记忆。支持任何语言。
上下文压缩:当 OpenClaw 压缩长对话时,插件会先捕获对话记录,不会丢失任何内容。
消息去重:线程追加按消息 ID 幂等,不会出现重复内容。
常见问题
AI 每次回答前都会搜索记忆吗?
插件通过两层机制驱动记忆召回。第一层是行为技能(由 OpenClaw 自动发现),教会 AI 何时以及如何使用记忆工具。第二层是始终在线的系统提示,提醒 AI 在回答关于过去工作、决策或偏好的问题之前先搜索记忆。实际使用中,现代 LLM 会可靠地遵循这种指令式引导。对于不需要历史上下文的消息(比如「你好」「谢谢」),AI 会跳过搜索,这是正确的权衡。如果你需要确保每次都有完整的记忆上下文,开启 sessionContext: true,它会在 AI 处理消息之前就注入相关记忆。
怎么防止 AI 重复保存同一件事?
两层防护。第一,插件在每次保存前都会检查是否已有高度相似的记忆,如果相似度极高,保存会被跳过,返回已有记忆的信息。第二,Nowledge Mem 的后台智能在后台运行更深层的去重,它识别记忆之间的语义重叠,并通过 EVOLVES 链(替代、丰富、确认或挑战)建立关联。插件处理明显的重复;后台智能处理微妙的重复。
没有主动保存的对话会怎样?
sessionDigest 默认开着:你在 OpenClaw 里的一次正常聊天,会落成 Mem 里的一条线程。边界跟着 OpenClaw 自己的会话生命周期走:当前这段聊天对应一条线程,执行 /new 或 /reset 会开始一条新线程,而 compaction 只是内部整理,不会把同一段聊天拆成第二条线程。Context Engine 路径和 hook 路径仍然会落到同一条对话上。像 temp:* 这样的内部辅助会话、subagent 会话会被过滤掉,最近线程列表里只保留真正的聊天。之后你可以用 nowledge_mem_thread_search 找回来。顺带还会跑一次轻量筛选,值得留的才提炼成结构化记忆,闲聊通常只保留在线程里。后台 cron 不走这条路径。
记忆会过时吗?
会,这是设计的一部分。Nowledge Mem 的 EVOLVES 链追踪认知如何变化:新的记忆可以替代、丰富或挑战旧的记忆。后台智能自动识别这些关系。搜索时,相关性评分会考虑时间因素,更新的记忆默认排名更高。
配置
正常通过 npm 安装时,开箱即用。安装器已经帮你启用了插件并选好了 memory slot。
修改设置:打开 OpenClaw 控制面板,进入 Automation > Plugins。在 Plugin Entries 下展开 Nowledge Mem,再展开 Nowledge Mem Config。也可以在搜索栏输入"nowledge"直接定位。
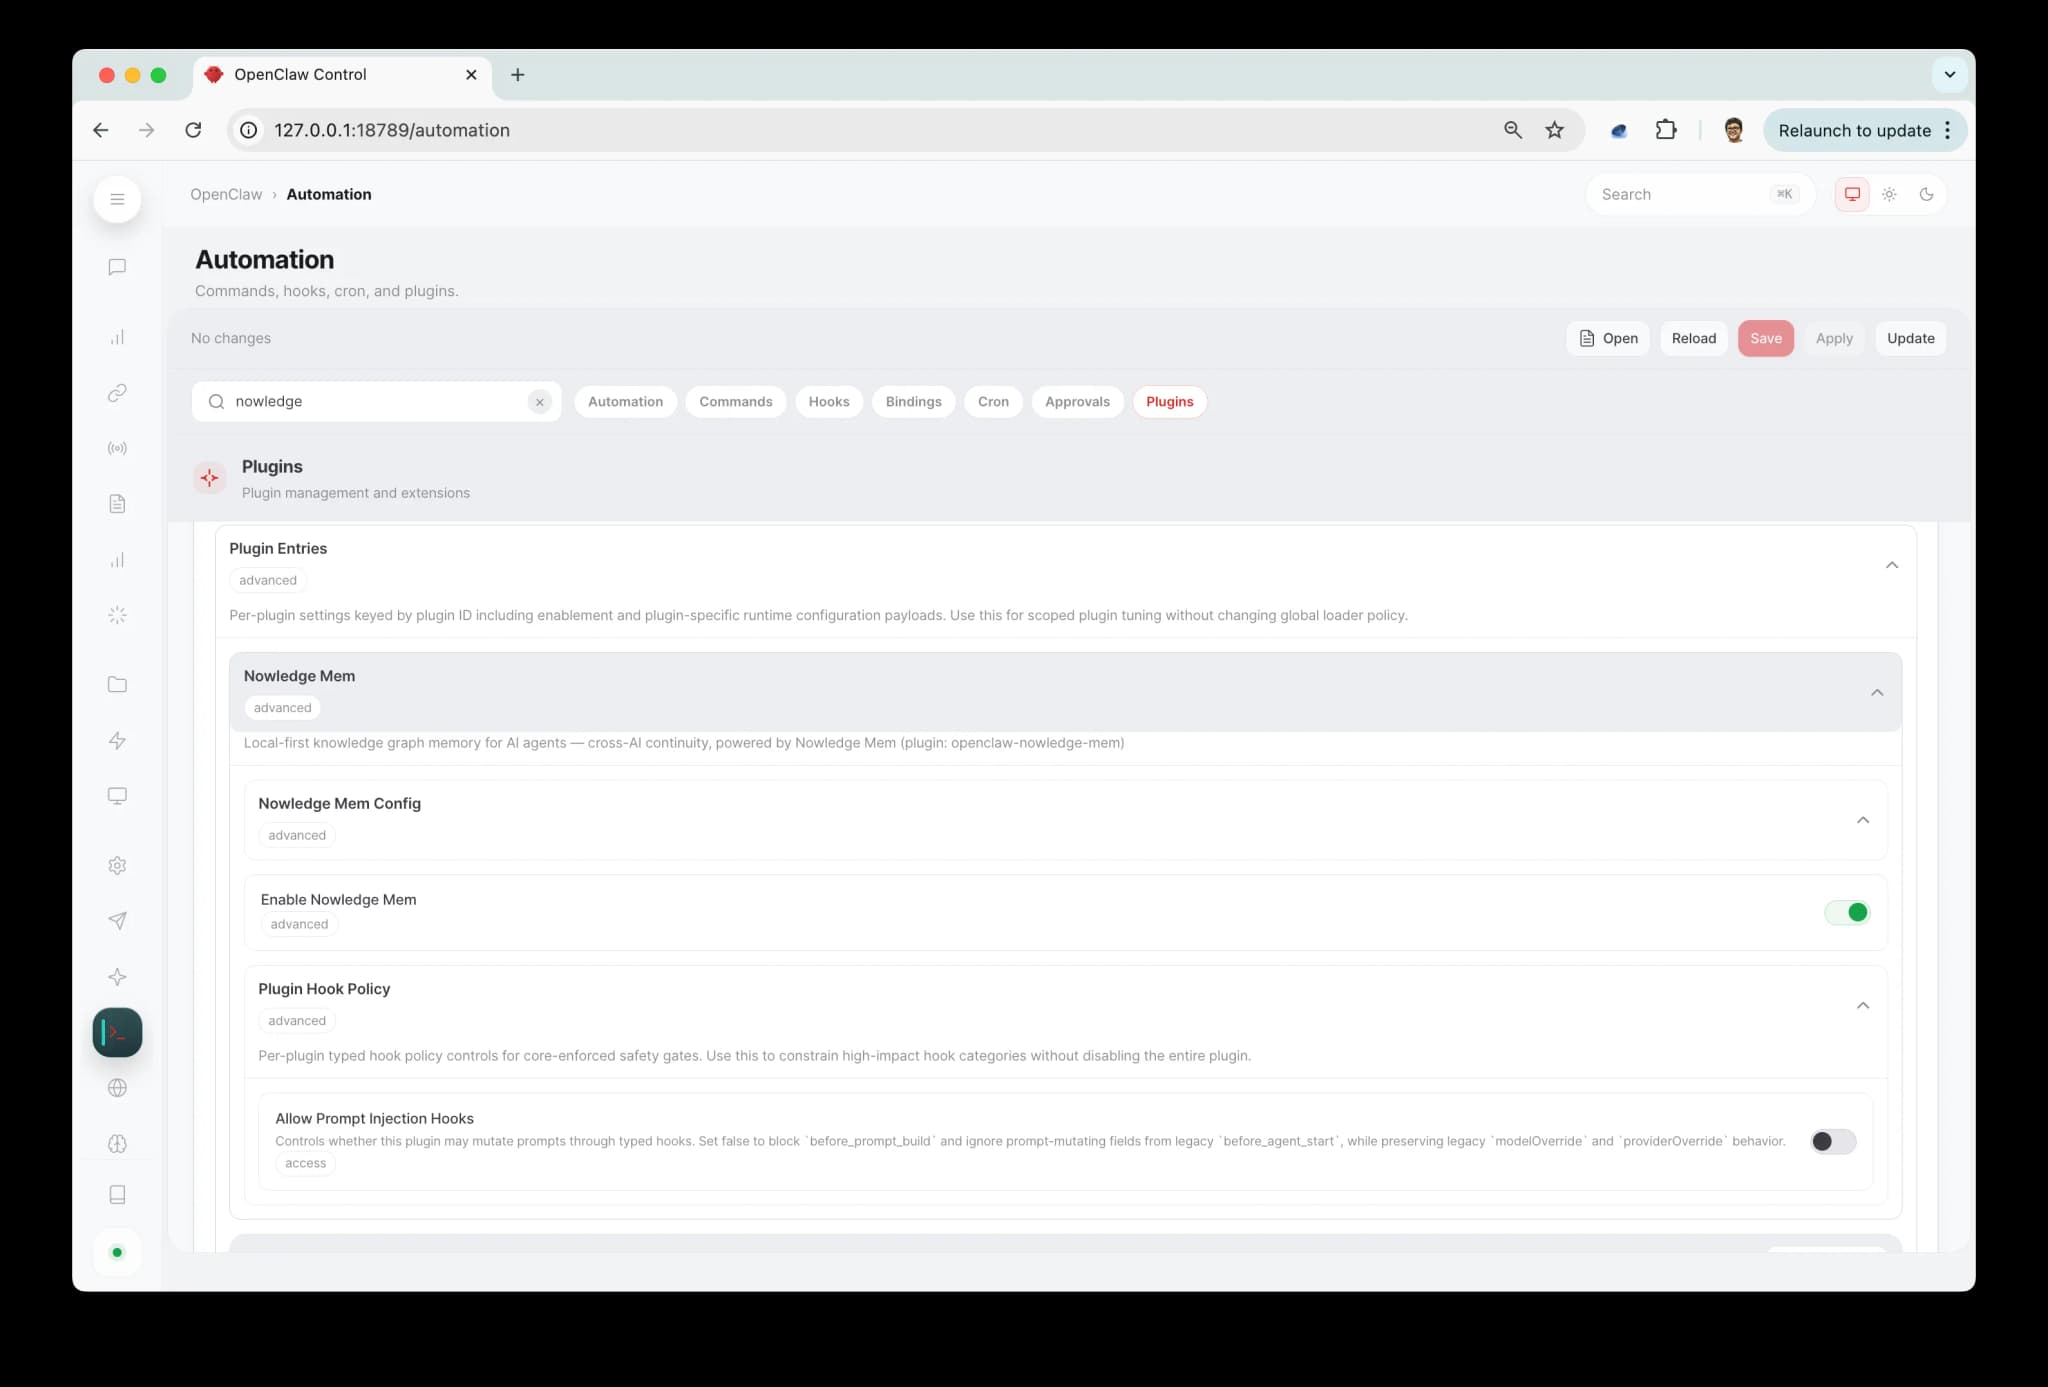
修改后重启 OpenClaw 生效。
| 设置 | 默认值 | 说明 |
|---|---|---|
| Session context injection | 关 | 每次提示时注入 Context Bundle / Working Memory 和相关记忆 |
| Session digest at end | 开 | 会话结束时捕获对话 + 提炼关键记忆 |
| Minimum digest interval | 300s | 会话提炼最短间隔秒数(0 = 无限制) |
| Max context results | 5 | 注入的记忆数量(1-20) |
| Min recall score | 0 | 仅注入相关性高于此阈值的记忆(0-100%),0 表示全部包含 |
| Max thread message chars | 800 | 每条捕获线程消息保留的最大字符数(200-20000),长代码或技术对话可适当调高 |
| Corpus supplement | 关 | 将你的知识接入 OpenClaw 的 dreaming 系统(详见下方) |
| Corpus max results | 5 | 每次 dreaming 搜索返回的最大结果数(1-20) |
| Corpus min score | 0 | dreaming 结果的最低分数(0-100%),0 表示全部包含 |
| Dreaming | 由 OpenClaw 管理 | 可选的 OpenClaw dreaming 设置。当 Nowledge Mem 占用 memory slot 时,OpenClaw 可能会把原生 dreaming 对象写在这里。真正运行 dreaming 引擎的仍然是 memory-core。 |
| Server URL | 空 | 远程服务器 URL(留空 = 本地) |
| API key | 空 | 远程模式 API 密钥 |
远程访问
连接另一台机器上的 Nowledge Mem 服务器:先在这台机器上执行一次:
nmem config client set url https://<your-url>
nmem config client set api-key nmem_...这会写入这台机器上的共享客户端配置,nmem、OpenClaw、Bub、Claude Code 等连接都会复用它。也可以在 OpenClaw 仪表盘的插件设置中填写 Server URL 和 API key。插件内部无论走哪条路径,都会复用同一组解析后的凭据:基于 CLI 的记忆工具和基于 API 的线程同步都会使用同一个 apiUrl 与 apiKey。API 密钥不会出现在日志或命令行历史中。详见:随处访问 Mem。
遇到问题?
插件装了,但 OpenClaw 好像没在用它
检查 plugins.slots.memory 的值是否正好是 openclaw-nowledge-mem,确认修改配置后重启了 OpenClaw。
plugins.allow is empty 警告
这表示 OpenClaw 发现了一个非内置插件,但你还没有把它加入显式信任列表。如果这是你通过 npm 安装的插件,可以加入:
{
  "plugins": {
    "allow": ["openclaw-nowledge-mem"]
  }
}
如果你还配置了 plugins.load.paths 或本地 link 版本,也要一起检查。OpenClaw 的 allowlist 只按插件 id 生效,不会固定到某个来源路径。
"Duplicate plugin id detected" 警告
如果你之前本地安装过插件(例如使用 --link),之后又从 npm 安装, OpenClaw 会同时从两处加载。解决方法:删除配置中指向本地插件目录的 plugins.load.paths 条目。
打开 ~/.openclaw/openclaw.json,删除指向本地插件目录的 plugins.load.paths 条目:
"load": {
  "paths": []
}
然后重启 OpenClaw。警告会消失,只会加载 npm 安装的版本。
status 显示无法连接
nmem status
curl -sS http://127.0.0.1:14242/health
记忆工具能用,但这段会话本身没有出现在 Threads 里
在正常聊天会话里运行 nowledge_mem_status,重点确认:
sessionDigest仍然开启- 后端可达
- 当前走的是哪条捕获路径
- 最近有没有改过插件设置但还没重启 OpenClaw
如果你启用了 plugins.slots.contextEngine: "nowledge-mem",那么插件 0.8.6+ 会把生命周期钩子保留下来,作为线程同步的兜底。在当前一些 OpenClaw 安装器版本里,这个值也可能被自动写成 openclaw-nowledge-mem;插件 0.8.18+ 会把它当作同一个引擎处理。若你还在 0.8.5 或更早版本,一个很有效的隔离方法是先临时移除 contextEngine slot,重启 OpenClaw,再看 hook-only 路径下线程捕获是否恢复。
如果是在升级 OpenClaw 后,线程突然不再更新,先升级 Nowledge Mem 插件,然后重启 OpenClaw。插件 0.8.24+ 已经适配 OpenClaw Codex runtime 新的逐轮捕获事件。插件 0.8.27+ 也适配了会报 must declare contracts.tools before registering agent tools 的新版 OpenClaw;这个报错表示 OpenClaw 在捕获钩子运行前就拒绝了插件工具注册。
要注意:OpenClaw 的插件设置是在重启后才真正生效的。如果你之前把 sessionDigest 关掉了,但当时还没重启,线程同步可能会暂时看起来还在继续;等到下一次重启后,才会真正停下来。
健康的 OpenClaw 线程同步,表现应该是这样:
- 一段你看得见的当前聊天,只对应 Mem 里的一条线程
- 运行
/new或/reset后,会开始一条新的 Mem 线程 - compaction 不会把同一段聊天拆出第二条线程
temp:slug-generator这种辅助会话不会出现在列表里/new或/reset的启动提示,不会被保存成第一条用户消息
想直接看最近同步进来的 OpenClaw 线程,可以运行:
nmem t list --source openclaw -n 20只有 memory_search 和 memory_get 能用,保存的内容却写进了本地文件
这通常是因为记忆插槽仍然指向 OpenClaw 内置的 memory-core,而不是 Nowledge Mem。OpenClaw 3.22 起,如果配置中没有显式指定记忆插槽,会默认使用 memory-core。如果你是手动安装插件、或在升级过程中配置被重置过,插槽可能需要重新设置。
确认配置中有显式的插槽声明:
{
  "plugins": {
    "slots": { "memory": "openclaw-nowledge-mem" }
  }
}
或者重新安装,安装命令会自动设置插槽:
openclaw plugins install clawhub:@nowledge/openclaw-nowledge-mem改完后重启 OpenClaw。
插件工具不可用
插件工具在插件被允许加载后会自动注册。确保插件在 plugins.allow 中:
{
  "plugins": {
    "allow": ["openclaw-nowledge-mem"]
  }
}
不要在 tools.allow 中填入 nowledge_mem_* 工具名:OpenClaw 会静默丢弃只包含插件工具的允许列表。tools.* 这边什么都不用配。
多个代理并发运行时搜索变慢
同时运行很多代理(10 个以上)时,搜索性能可能下降,因为所有操作共用一条数据库连接。建议:
- 升级到 Nowledge Mem v0.6.12+(后端):搜索响应不再被计分写入阻塞
- 如果代理走的是 CLI 通道,可以在插件配置中设置远程 API 地址,以减少子进程开销
搜索只找到一两条结果
把 maxContextResults 调高到 8 或 12。
为什么用 Nowledge Mem 而不是其他方案?
其他记忆工具把你说过的话存成一段段文字,靠语义相似度找回来。Nowledge Mem 不一样。
知识是有结构的。 你保存的每条记忆都知道自己是什么类型(决策、学习、计划还是偏好),知道它什么时候发生、指向哪些来源文档、和哪些其他记忆有关联。这让搜索更准、推理更靠谱。
知识会演化。 你今天写的理解,和三个月后更新过的认识,在系统里是连在一起的。你可以看到自己的想法怎么变化的,不会丢掉中间的过程。
知识来自哪里是透明的。 从 PDF、文档或网页提取的每条知识,都保留着指向原始文件的链接。AI 告诉你"根据你三月份的设计文档",你能直接验证。
跨工具共享。 在 Cursor 里学到的,在 Claude 里记下的,在 OpenClaw 里一样能用。你的知识不属于任何一个工具,它属于你。
本地优先,无需云账户。 你的知识存在本地。远程访问是可选的,不是必须的。
搜索怎么工作的?参见搜索与相关性。
与 memory-core 协同(v0.8.0+)
默认配置下,Nowledge Mem 接管 memory slot。你可以使用完整的工具集、跨工具知识图谱和结构化记忆类型。大多数用户应该保持这个配置。
有些用户更习惯保留 OpenClaw 内置的 memory-core 作为 memory slot,因为 memory-core 有自己的特色功能:MEMORY.md 管理、dreaming(实验性的记忆整合系统),以及和 OpenClaw 原生召回管线的深度整合。
插件同时支持两种路径。开启 corpusSupplement 后,memory-core 的召回管线可以直接搜索你的 Nowledge Mem 知识图谱。你在 Claude、Cursor、ChatGPT 或其他工具中保存的记忆,会出现在 memory-core 的搜索结果中,也会参与 dreaming。
这个组合请使用 0.8.15 或更高版本。更早的构建里,插件在 memory-core 旁边可能会实际失活,于是有些用户只能手动修改本地源文件,才能让 supplement 模式继续工作。
corpus supplement 做了什么
当 memory-core 执行搜索时,它也会同时查询 Nowledge Mem。你的知识图谱中的结果和 memory-core 自身的结果一起排序和评分:
- memory-core 的召回会包含你的跨工具知识
- Dreaming(实验性)可以把高频召回的 Nowledge Mem 内容提升到
MEMORY.md - 每周模式提取可以发现知识图谱与 memory-core 数据之间的关联
配置方式
保持 memory slot 为 memory-core(或不设置)。在插件设置中打开 corpusSupplement: true,或通过环境变量 NMEM_CORPUS_SUPPLEMENT=true。
插件会自动处理去重。当 Nowledge Mem 是 memory slot 时,它直接处理召回;当 memory-core 是 memory slot 且 corpus supplement 开启时,它接入 memory-core 的管线。同一条内容不会出现两次。
如果你在 Nowledge Mem 这个插件条目下看到顶层的 dreaming 对象,也不用担心,这属于正常现象。新版 OpenClaw 会把 dreaming 设置写到当前选中的 memory-slot 插件上。Nowledge Mem 只负责接受这份配置,不会自己实现 dreaming 引擎;真正运行 dreaming 的仍然是 memory-core。
怎么选
| 配置 | 适合场景 |
|---|---|
| Nowledge Mem 作为 memory slot(默认) | 完整的 10 个工具、结构化记忆类型、对话溯源。一个系统管理一切。 |
| memory-core + corpus supplement | 你在用 memory-core 的 MEMORY.md 工作流,或者想用 dreaming。跨工具知识仍然会接入。 |
两种配置下,对话捕获和蒸馏的效果是一样的。区别在于由哪个系统负责召回和长期整合。
上下文引擎(v0.7.0+)
从插件 v0.7.0 起,Nowledge Mem 可以作为 OpenClaw 的完整上下文引擎运行,而不仅仅是提示钩子。这让它能更深入地参与 OpenClaw 的生命周期:
- 记忆感知的上下文压缩:当 OpenClaw 压缩长对话时,你知识图谱中已保存的关键决策和经验会以引用方式保留,不会在摘要过程中丢失
- 子代理记忆继承:当 OpenClaw 启动并行研究代理时,它们会自动继承你的记忆上下文
- 会话预热:Context Bundle 或 Working Memory 在第一轮对话前就加载好,上下文从一开始就已就绪
- 逐轮捕获:对话在每轮结束后都会被捕获,而不只在会话结束时
激活方式:在 OpenClaw 配置中添加:
{
  "plugins": {
    "slots": {
      "memory": "openclaw-nowledge-mem",
      "contextEngine": "nowledge-mem"
    }
  }
}
如果不激活上下文引擎,现有的钩子模式会继续正常工作。
如果激活了,上下文引擎负责提示词组装和逐轮捕获;生命周期钩子则继续留作线程同步的兜底路径。这样分工是刻意设计的:上下文注入不会重复,线程同步也不会把成败压在单一路径上。
给进阶用户
OpenClaw 的 MEMORY.md 工作区文件仍然有效,但记忆工具的实际调用全部由 Nowledge Mem 处理。两者可以共存。
插件内部使用同一套连接配置,但不强行走同一种传输方式。大多数记忆操作仍通过 nmem 完成;对话线程同步则直接请求 Mem 服务器,这样长会话会通过正常的请求体传输,而不是塞进一条很长的命令行参数。对用户来说不需要学两套配置:地址和密钥只配一次,本地模式和远程模式都按同样的方式工作。
相关
- 连接总览 - 原生连接、复用包、MCP 与浏览器捕获
- Claude Code · Claude Desktop · Codex · Alma · Raycast · 内置 Web 聊天
参考
- 插件源码:nowledge-mem-openclaw-plugin
- OpenClaw 文档:插件系统
- 更新日志:CHANGELOG.md