検索と関連性
Nowledge Memがメモリをどのように見つけ、ランク付けするか
Nowledge Memが一致するメモリをどのように見つけ、関連性でランク付けし、あなたの利用パターンから学習するかを説明します。
スコアリングパイプライン
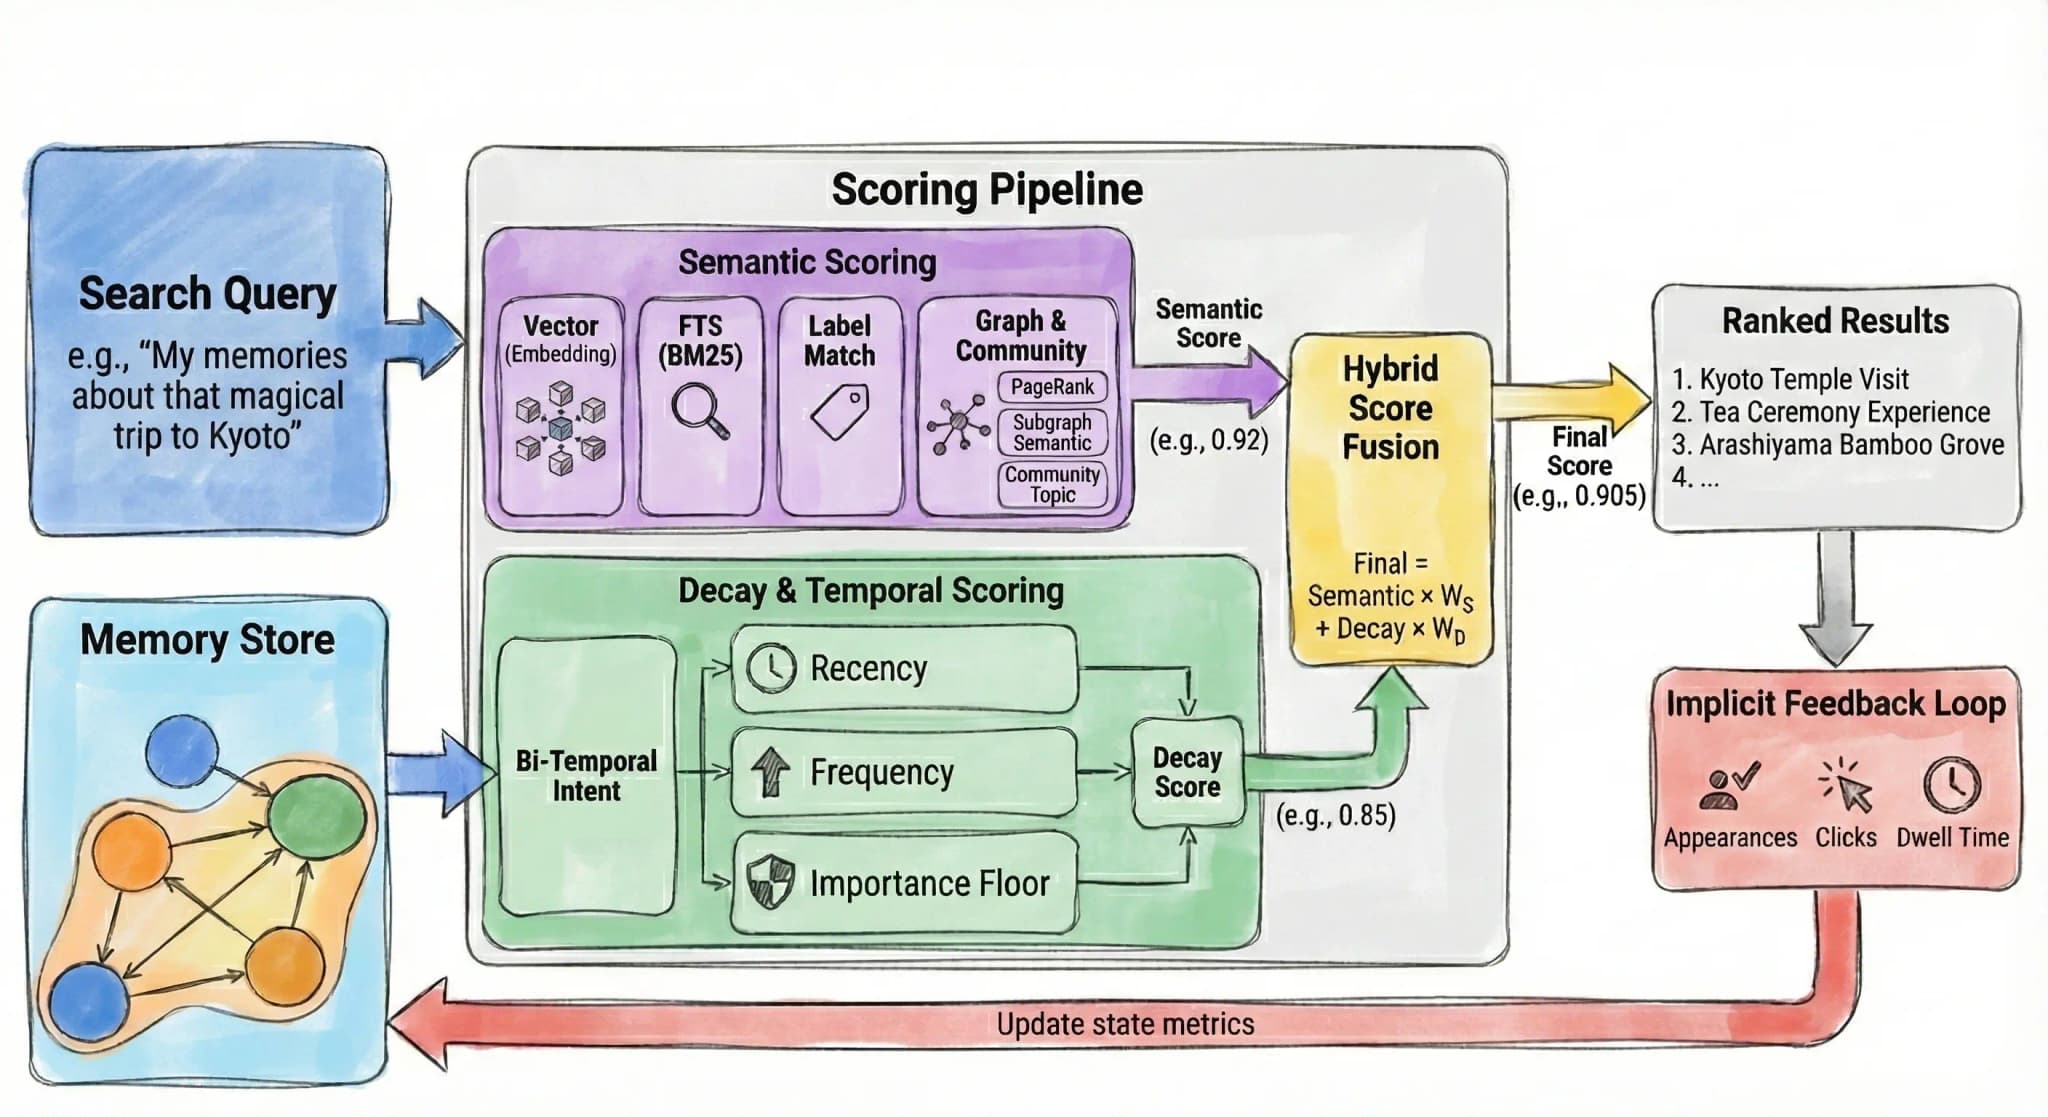
検索は複数のシグナルを組み合わせて、キーワード一致を超えたランキングを行います。
セマンティックスコアリング
このトラックは、あなたが探しているものに一致するメモリを見つけます:
- 意味ベースの検索: 完全一致の単語だけでなく、意味的な類似性でメモリを見つけます。 「design patterns」を検索すると、「architectural approaches」に関するメモリが見つかります。
- キーワード検索: BM25ランキングを使用して、正確なフレーズや技術用語を捉えます。
- ラベルマッチング: 一致するタグを持つメモリを浮かび上がらせます。
- グラフトラバーサル: エンティティとトピックコミュニティを通じて、つながりのあるメモリを発見します。
減衰、信頼度、時間スコアリング
このトラックは、鮮度、検証、およびあなたの利用状況に基づいて結果を調整します:
- 新しさ: 最近アクセスされたメモリはより高くスコアされます。 半減期が約30日の指数関数的減衰を使用します。
- 頻度: 繰り返しアクセスするメモリはより持続的になります(収穫逓減を伴う対数スケーリング)。
- 重要度フロア: 重要度の高いメモリは、使用されなくても最低限のアクセス可能性を維持します。
- 信頼度: 利用とナレッジグラフの接続を通じて検証されたメモリには、さりげないブーストがかかります。 信頼度は証拠とともに成長し、決して減少しません。
- 時間マッチング: イベント時刻がクエリに一致するメモリをブーストします(ディープモードのみ)。
これらのトラックは最終スコアに統合され、結果のランキングを決定します。
メモリの減衰
メモリは、使用によって強化されない限り、時間とともに薄れていきます。
仕組み
新しさ: 昨日アクセスされたメモリは、3か月前のものよりもはるかに高くスコアされます。 半減期が30日ということは、アクセスがない場合、スコアは毎月およそ半分になることを意味します。
頻度: メモリへの10回目のアクセスは、100回目よりも重要です。 これは人間の記憶の仕組みを反映しています。 初期の反復は持続性を築き、後の反復は収穫逓減となります。
重要度フロア: 重要度が高いとマークされたメモリは、完全には減衰しません。 触れられなくても、最低限のアクセス可能性を維持します。 これにより、基盤となる知識が薄れていくのを防ぎます。
検索による強化
v0.6.6 以降
v0.6.6以降、検索に表示されるたびにメモリの最終アクセス時刻とアクセス回数が更新され、鮮度スコアが自動的に強化されます。
以前は、明示的なクリックのみが鮮度を更新していました。 現在では、検索結果に表示されることが軽度のアクセスとしてカウントされ、活発に関連するメモリが薄れていくのを防ぎます。
信頼度
v0.6.7 以降
信頼度スコアリングは、毎日の鮮度リフレッシュ中に計算されます。
減衰とは別に、各メモリはどれだけよく検証されているかを反映する 信頼度スコア を構築します。 信頼度はベースラインから始まり、証拠が蓄積されるにつれて成長します:
- 検索利用: 表示、クリック、閲覧時間
- ナレッジグラフ: 他のメモリによって確認または強化されたメモリ、あるいは結晶化された知識のソースとして使用されたメモリ
時間とともに薄れる減衰とは異なり、信頼度は増加するだけです。 頻繁にアクセスされ、クリックされ、他の知識と接続されたメモリは、同じセマンティック一致を持つ新しく作成されたものよりも高くスコアされます。
影響はさりげないものですが(信頼度は最終スコアの約5% を占めます)、確立された知識に一貫した優位性を与えます。
これが意味すること
- 検索結果に表示されるメモリを含め、活発な知識は新鮮に保たれます
- 古いメモリは消えません。 同等に関連する場合、ランクが低くなるだけです
- 重要な知識はアクセスパターンに関係なく持続します
- よく検証されたメモリには、さりげないランキングブーストがかかります
- システムはあなたの行動から自動的に学習します
自動メンテナンス
v0.6.6 以降
これらの機能は、設定 → 処理 → 詳細 からオプトインできます。
減衰スコアを正確に保ち、メモリの品質を高く維持するために、Nowledge Memはバックグラウンドメンテナンスを実行できます:
- 鮮度リフレッシュ: 毎日のタスクがすべてのメモリの減衰スコアと信頼度スコアを再計算するため、最近触れていないメモリでもランキングが最新に保たれます。 これはスコアのみを変更します。 メモリのアーカイブ、マージ、削除、書き換えは行いません。
- メモリメンテナンス: レビュー優先のタスクがメモリの増加圧力を探します。 日常的な想起から外れる可能性のある、古い低リスクの事実やイベント、およびセマンティックな整理が必要かもしれない保護された知識について、タイムラインレビューを準備できます。
- コンパクション: 毎週のタスクが類似または冗長なメモリのクラスタを特定し、リンク、要約、またはレビュー項目を作成できます。 保存されたメモリのテキストを黙って削除することは決してありません。
時間の理解
Nowledge Memは2種類の時間を理解します。
イベント時刻と記録時刻
イベント時刻 は、何かが実際に起こった時です:
- 「2020年の製品ローンチ」
- 「前四半期の決定事項」
- 「移行する前に」
記録時刻 は、あなたがメモリを保存した時です。 2020年のイベントについて、今日メモリを記録することがあります。
これは「2020年のイベントに関する最近のメモリ」のようなクエリで重要です。 最近保存したもの(記録時刻)で、2020年のイベント(イベント時刻)に関するものです。
時間意図の検出
ディープモード機能
時間意図の検出にはディープモード検索が必要です。 ファストモードでは、時間参照はキーワードのみで一致されます。
ディープモードでは、システムが時間参照を解釈します:
| クエリ | 理解 |
|---|---|
| 「2023年の決定事項」 | イベント時刻: 2023 |
| 「最近のメモリ」 | 記録時刻: 最近 |
| 「2020年についての最近のメモリ」 | イベント: 2020、記録: 最近 |
| 「移行の前に」 | イベント: そのイベントの前 |
「前四半期」「2020年頃」「今年の初め」のような曖昧な参照は、意味のあるフィルタに変換されます。
日付の精度
「2020年初頭」についてメモリを保存すると、システムは:
- 検索可能な日付(2020-01-01)に正規化します
- 精度レベル(年、月、または日)を追跡します
- 正確なマッチングのために元の意味を保持します
これにより、「2020年のメモリ」(年精度)が「2020年1月のメモリ」(月精度)とは異なる動作をします。
フィードバックループ
あなたの利用パターンが検索の関連性を継続的に改善します。
追跡するもの
| シグナル | 捉える内容 |
|---|---|
| 表示 | メモリが結果に表示される頻度 |
| クリック | 詳細を表示するためにメモリを開く時 |
| 滞在時間 | 読むのに費やす時間 |
検索がどのように改善されるか
- 高いクリック率は、そのメモリが本当に有用であることを示します
- 長い滞在時間は、価値のあるコンテンツを示唆します
- クリックなしで頻繁に表示される場合は、関連性の低下を示している可能性があります
必要な操作はありません。 関連性は通常の使用で改善されます。
自動ラベリング
v0.6.7 以降
ラベルは、新しいメモリが作成されると自動的に割り当てられます。
メモリを作成すると、バックグラウンドインテリジェンスがその内容を読み取り、2〜4個の説明的なラベルを割り当てます。
適合する場合は既存のラベルを再利用し、一貫した小文字ハイフン区切りの規則(machine-learningやproject-alphaなど)に従います。
これにより、手動でタグ付けしなくても、メモリは最初から整理されます。
グラフを活用した発見
ナレッジグラフは、エンティティとトピックの接続を通じた発見を可能にします。
メモリがどのように接続するか
各メモリは以下にリンクできます:
- エンティティ: 言及された人物、概念、技術、場所
- 他のメモリ: 共有されたエンティティまたは関係を通じて
- コミュニティ: グラフ分析が検出したトピッククラスタ
接続を通じた検索
エンティティ媒介: PostgreSQLやインデックス作成のような共有エンティティを通じて、異なるタグが付けられていても「データベース最適化」に関するメモリを見つけます。
コミュニティ媒介: 「認証」に関する検索で、「セキュリティプラクティス」コミュニティのメモリが浮かび上がることがあります。
グラフ拡張: 1つのメモリから始めて、接続された知識を探索します。
検索モード
すべてのインターフェースで利用可能な2つのモード:
ファストモード
- 通常100ms未満の応答
- 直接的なセマンティックおよびキーワードマッチング
- 言語モデル分析なしのエンティティおよびコミュニティ検索
- 素早い検索に最適
ディープモード
- 完全な言語モデル分析
- 時間意図の検出(例:「最近取り組んでいる;過去10年間の社会的イベント」)
- より良い想起のためのクエリ拡張
- コンテキストを考慮した戦略の重み付け
- 探索的な検索に適している
どちらのモードも、メイン検索、グローバルランチャー、APIで動作します。
結果の透明性
すべての結果は、なぜその順位になったかを示します。
検索クエリの詳細
各検索の後、クエリがどのように解釈されたかの詳細な分析を表示できます:
- どの検索戦略が使用されたか
- 時間意図の検出結果(ディープモードの場合)
- クエリ拡張とエンティティ抽出
スコアの内訳
任意の結果のスコアにカーソルを合わせると、どのように計算されたかの内訳が表示されます:
- セマンティックスコア: コンテンツがクエリにどれだけ一致するか
- 減衰スコア: 新しさと頻度に基づく鮮度
- 信頼度: 利用とグラフ接続を通じてどれだけ検証されているか
- 時間ブースト: イベント時刻の関連性(該当する場合)
- グラフシグナル: エンティティとコミュニティの接続
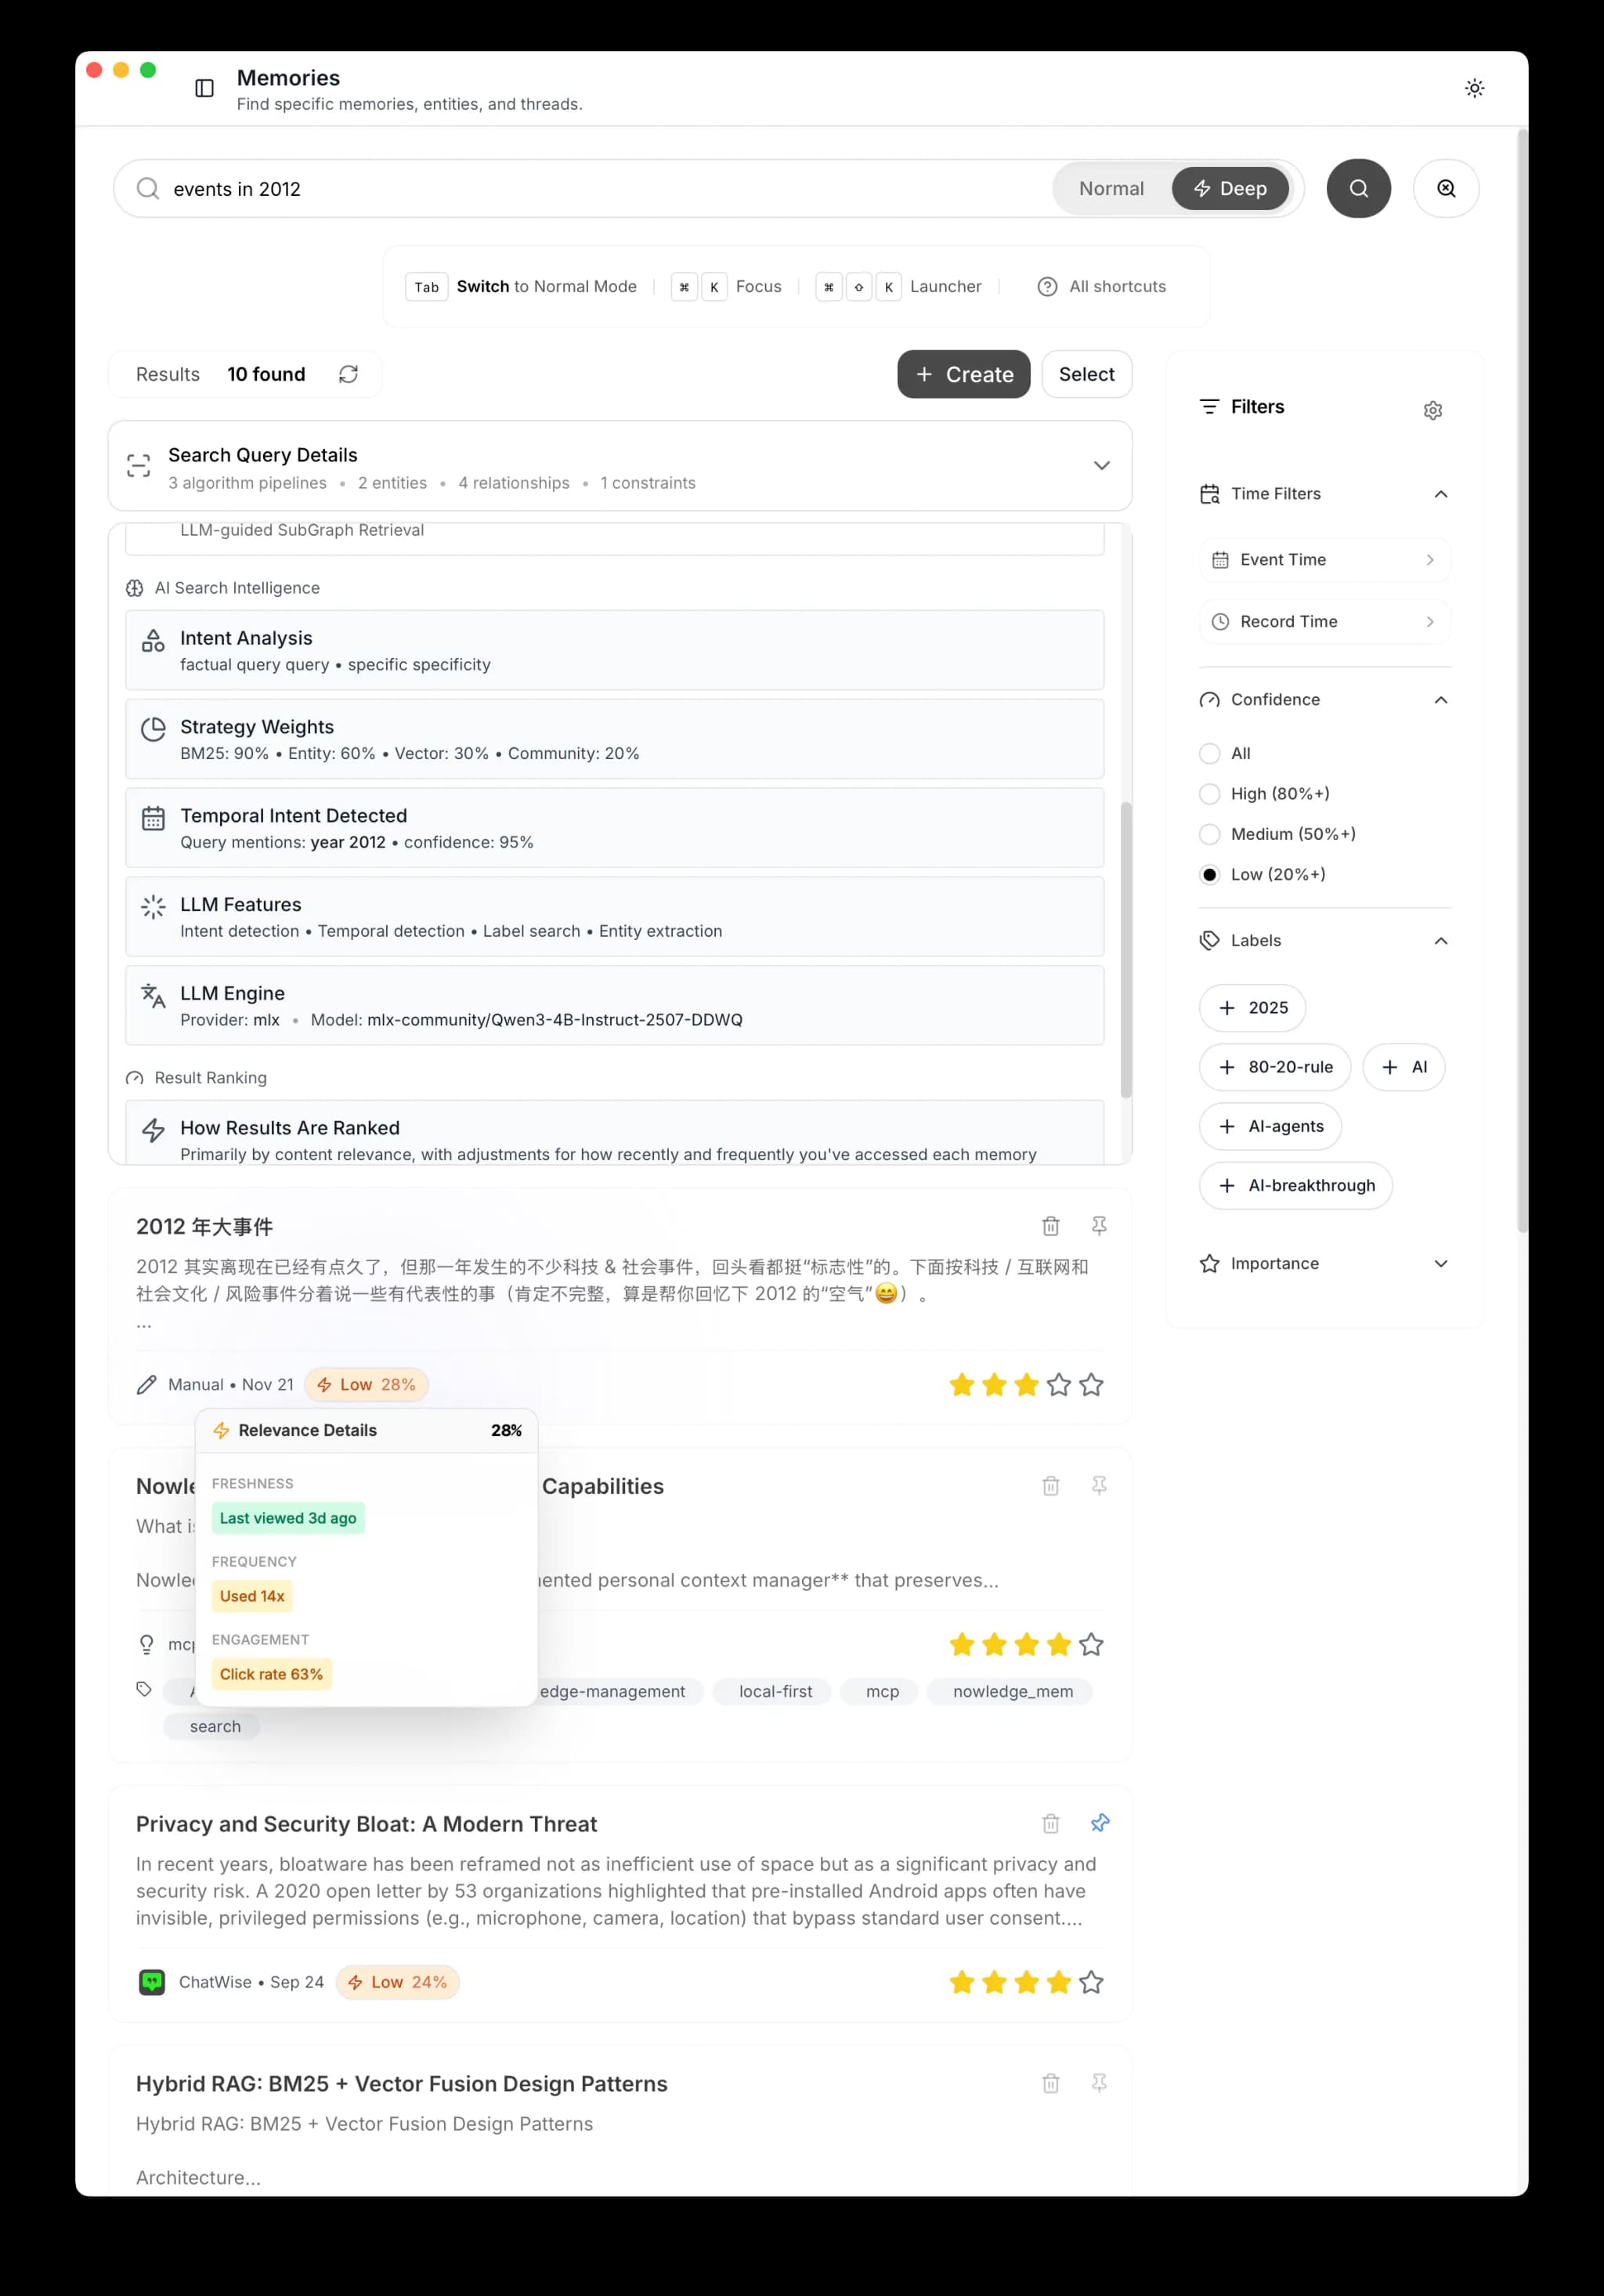
これにより、利用パターンがランキングにどのように影響するか、そして特定のクエリでなぜ特定のメモリが表示されるかが明確になります。